OpenAI 的 Data Agent,与「从答案走向可复用产物」的转向
💡 工具推荐:AI 数据分析, AI SQL 优化, AI Token 计数器
2026 年 9 月 10 日,OpenAI 在 ChatGPT Work 中发布了 Data agent。官方页面用一句话概括它的能力:连接你公司的数据、调查发生了什么变化,并构建你可以共享的交互式仪表盘;它出现在 ChatGPT Work 的插件目录里(名字就叫 Data),由管理员在 Workspace settings > Plugins 中决定谁能用、并为团队安装,同时可以启用和配置具体的数据源插件,例如 Databricks 与 Snowflake(OpenAI 官方发布页,2026 年 9 月 10 日)。真正值得关注的不是模型,而是交付物的变化:过去你拿到的是一段回答,现在你拿到的是一个会被团队反复打开的产物。
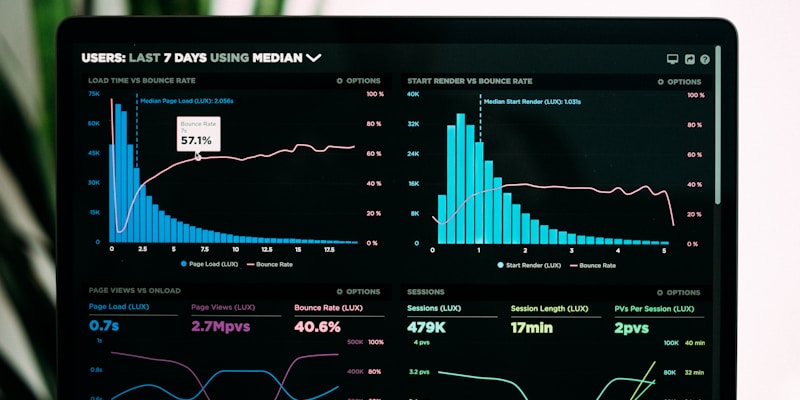
交付物从答案变成可复用的仪表盘
一、交付物换了,契约就换了
官方描述里有三个动词:连接、调查、构建。第三个动词才是分水岭——输出不再是分析段落,而是下周还能被打开、被编辑、被分享的制品。这带来一个直接的后果:任何被反复打开的东西都会变成事实来源。一个写在聊天窗口里的错误结论,几小时后会随对话消失;一个写进仪表盘里的错误指标,会在季度会上被当成基准。所以分析类智能体的验收标准,不应该只是「答案听起来对不对」,而应该是「这个产物在两周后是否还站得住」。
# semantic/metrics.yml - the agent is only as honest as your definitions
metrics:
  net_revenue:
    definition: "gross_revenue - refunds - chargebacks"
    owner: finance-ops
    source: warehouse.fact_orders
    freshness_sla: "4h"
    dimensions: [region, segment, channel]
    tests:
      - not_null(gross_revenue)
      - net_revenue <= gross_revenue
      - abs(net_revenue - (gross_revenue - refunds - chargebacks)) < 0.01

# An analytics agent asked "why did sales slow down" will answer with
# whatever your definitions say. Version the definitions, and the answer
# becomes reproducible instead of improvised.
连接器插件就是权限边界
二、管理员在管什么
OpenAI 把访问控制放在插件层:管理员通过 Workspace 设置决定 Data agent 是否对团队可用,并单独启用、配置数据源插件(官方点名的例子包括 Databricks 与 Snowflake),同时管理这些插件的使用者范围。这套设计的含义很清晰:智能体能看到什么,不由提示词决定,而由你装了什么连接器决定。于是「数据治理」这件事从抽象原则变成了具体动作——每新增一个连接器,就相当于给分析智能体新增一片可读区域。连接器清单,就是权限边界。
-- metric_guard.sql - fail the build when a metric drifts
WITH current AS (
  SELECT date_trunc('day', order_ts) AS day,
         SUM(gross_revenue - refunds - chargebacks) AS net_revenue
  FROM fact_orders
  GROUP BY 1
), baseline AS (
  SELECT day, net_revenue
  FROM metric_snapshots
  WHERE snapshot_date = CURRENT_DATE - INTERVAL '7 days'
)
SELECT c.day,
       c.net_revenue                            AS today,
       b.net_revenue                            AS week_ago,
       ROUND(100 * (c.net_revenue / NULLIF(b.net_revenue, 0) - 1), 2) AS pct_change
FROM current c
LEFT JOIN baseline b USING (day)
WHERE ABS(100 * (c.net_revenue / NULLIF(b.net_revenue, 0) - 1)) > 15;

-- Any row returned is a metric definition change, not a business change.
-- Investigate before you let an agent narrate it to a board.
语义层决定了智能体的诚实度
三、分析类智能体最容易翻车的三处
第一处是语义漂移:同一个「净收入」,财务、增长与销售各自有三套口径,智能体只会忠实复现你给它的定义。第二处是连接器蔓延:为了「先跑起来」而接入的临时数据源,半年后会变成没人负责的常设通道。第三处是数据本身不可信:分析智能体是一台高效的指令消费者,只要它读取的表格、文档或工单里带着隐藏指令,它就会照做——这正是 OWASP 在其智能体安全报告中反复强调的提示注入面。这三处没有一个是靠换模型解决的。
# dashboards/revenue.yaml - dashboards are code, so they get reviewed
dashboard: net-revenue-overview
owner: finance-ops
version: 12
panels:
  - id: net_revenue_trend
    metric: net_revenue
    grain: day
    window: 90d
    annotations: [pricing_change, outage]
  - id: refund_rate
    metric: net_revenue_refund_rate
    grain: week
    alert: "> 3.5% for 2 weeks"
access:
  viewers: [finance, exec-staff]
  editors: [finance-ops]
refresh: "4h"

# The dashboard the agent builds becomes an artifact under version control,
# not a one-off reply that nobody can re-open next quarter.
四、把语义层当作产品来维护
要压住语义漂移,最有效的做法是把指标定义写成版本化文件,并给它配上测试:净收入必须等于毛收入减退款减拒付,且不能大于毛收入(代码示例 1)。再加一条每日守卫查询,当指标口径变化导致同比波动超过阈值时让构建失败(代码示例 2)。这套东西看起来和「AI」无关,但它决定了智能体是资产还是负债:口径可版本化,答案就可复现;口径靠口口相传,答案就只能靠运气。
# eval_analytics_agent.py - grade the agent on the questions you care about
CASES = [
    {"q": "Why did net revenue drop in EMEA last week?",
     "must_cite": ["net_revenue", "fact_orders"],
     "must_mention": ["refunds", "channel_mix"],
     "forbidden": ["invented_segment"]},
    {"q": "Which accounts are at renewal risk?",
     "must_cite": ["accounts", "usage_weekly"],
     "must_mention": ["seats_active", "open_tickets"]},
]

def score(answer, case):
    cited = set(answer["sources"])
    return {
        "grounded": set(case["must_cite"]) <= cited,
        "covered": all(k in answer["text"] for k in case["must_mention"]),
        "clean": not any(k in answer["text"] for k in case.get("forbidden", [])),
    }

# Run this on every prompt or model change. Ungraded analytics agents
# quietly become very confident liars.
五、产物、评测与成本:三段可以立即落地的工程
把仪表盘也纳入版本控制(代码示例 3),这样每次改动都有评审记录、有归属人、有告警阈值,而不是一个只在某人浏览器里存在的视图。再写一组评测用例,明确每个问题族必须引用的表、必须提到的维度、以及绝不能出现的内容(代码示例 4)——分析类智能体的失败方式通常是「自信地编造一个细分市场」,评测是唯一的解药。最后按「已答问题成本」记账,而不是按月度 token 数记账(代码示例 5)。
# budget.py - cost per question, measured per question family
LEDGER = {}

def track(family, tokens_in, tokens_out, cached_in, usd):
    row = LEDGER.setdefault(family, {"calls": 0, "usd": 0.0, "tokens": 0})
    row["calls"] += 1
    row["usd"] += usd
    row["tokens"] += tokens_in + tokens_out
    row["cost_per_question"] = round(row["usd"] / row["calls"], 4)
    return row

# Guardrails that matter for analytics work:
#   - cache the semantic layer and schema, not the question
#   - cap exploratory scans, log every one
#   - report cost per answered question, not tokens per month
六、三十天落地顺序
第一周,只开一个连接器、一个指标族、一组三个问题,把它跑通并记录准确率。第二周,把指标定义与测试写进仓库,让口径变更走评审。第三周,把仪表盘产物纳入代码库,接上告警阈值。第四周,做一次「回看」:随机抽取两周前的三份产物,检查结论是否仍然成立、成本是多少、谁批准的连接器。四周之后你得到的不是一个 demo,而是一条可追责的分析流水线——这也是把管理员权限用对地方的样子。
📌 常见问题 FAQ
OpenAI 的 Data agent 是什么?
根据 OpenAI 官方发布页(2026 年 9 月 10 日),它是 ChatGPT Work 中的插件:连接已批准的公司数据源、调查指标变化,并构建可共享的交互式仪表盘。管理员可在 Workspace 设置的插件目录中控制可用范围。
它和「对着数据库聊天」有什么区别?
交付物的形态不同。对话式分析产出段落,Data agent 产出可被团队再次打开的制品;制品会被当成事实基准,因此需要版本控制、归属人与告警阈值。
谁决定智能体能访问哪些数据?
管理员,通过启用与配置数据源插件。OpenAI 官方页面点名 Databricks 与 Snowflake 这类插件可被启用和配置,并可由管理员管理使用范围。
分析类智能体最常见的失败是什么?
语义漂移与自信编造。前者源于同一指标存在多套口径,后者源于缺少强制引用数据来源的评测。二者都要靠语义层版本化与评测用例解决。
该用什么成本指标管理分析智能体?
用「每个已答问题的成本」,而不是每月 token 总量。前者能反映架构效率,后者只会在月末变成一个无法归因的大数字。
🔧 推荐工具
📚 参考资料
- OpenAI — Now everyone can put data to work: Data agent in ChatGPT Work (Sept 10, 2026)
- HPCwire / BigDATAwire — OpenAI launches Data agent as enterprise analytics race heats up (Sept 11, 2026)
- Unite.AI — OpenAI introduces Data agent in ChatGPT Work (Sept 10, 2026)
- OWASP GenAI Security Project — State of Agentic AI Security and Governance 2.01